Ein Killswitch für das ganze Homelab
Wie wir bei einer kritischen Lücke ganze Gruppen von Diensten mit einer Zeile vom Internet nehmen, ohne dass intern etwas stillsteht.
Bei PHP2Shell war die Frage nicht, ob wir die PHP-Websites vom Netz nehmen, sondern wie schnell. Ohne vorbereiteten Mechanismus heisst das: jeden betroffenen Dienst einzeln anfassen, Router umschreiben, deployen, hoffen, dass keiner vergessen ging. Genau das wollen wir im Ernstfall nicht mehr tun. Entstanden ist ein Killswitch: ein Schalter pro Gruppe von Diensten, der sie für Besucher von aussen sperrt und intern alles weiterlaufen lässt.
Die Idee: Gruppen statt Einzeldienste
Eine Sicherheitslücke trifft selten einen einzelnen Dienst. Sie trifft eine Laufzeit (PHP, Java, Node.js …), ein Produkt (WordPress mit seinen Plugins) oder, im schlimmsten Fall, alles, etwa bei einer Lücke im Reverse Proxy selbst. Also bekommt jeder Dienst einmalig und dauerhaft die Gruppen, zu denen er gehört:
| Achse | Beispiel | Wann schalten |
|---|---|---|
| alles | killswitch-all | Verdacht auf Einbruch, laufender Angriff, Lücke im Proxy |
| Plattform | killswitch-php, killswitch-java, killswitch-nodejs … | Lücke in der Laufzeit |
| Produkt | killswitch-wordpress | Software mit eigenen, häufigen Lücken |
Im Normalbetrieb tun diese Gruppen nichts. Im Ernstfall wird eine Gruppe umgeschaltet, und alle Dienste darin sind für Externe gesperrt.
So funktioniert es
Alle Dienste laufen hinter Traefik. Jeder Dienst trägt seine Gruppen als Middleware an seinen Routern. Jede Gruppe ist ihrerseits nur ein Verweis auf einen von zwei Bausteinen: «aus» oder «an».
- Aus ist eine Middleware, die nichts Sichtbares tut.
- An ist eine Kette aus zwei Teilen:
- Eine Allow-List mit den eigenen Netzen. Wer von innen kommt, geht durch; wer von aussen
kommt, wird abgewiesen, und zwar mit dem eher ungewöhnlichen Statuscode
418. - Eine Fehlerseiten-Middleware, die genau diesen
418abfängt und durch eine Wartungsseite mit503undRetry-Afterersetzt.
- Eine Allow-List mit den eigenen Netzen. Wer von innen kommt, geht durch; wer von aussen
kommt, wird abgewiesen, und zwar mit dem eher ungewöhnlichen Statuscode
Der Umweg über 418 hat einen Grund: So ersetzt die Wartungsseite nur die Sperre selbst. Antwortet
eine Anwendung für einen internen Besucher mit 403, bleibt das ein 403 und wird nicht von der
Wartungsseite überdeckt.
Vereinfacht sieht das in der Traefik-Konfiguration so aus (Netze und Namen sind Beispiele):
http:
  middlewares:
    killswitch-off:
      headers:
        customRequestHeaders:
          X-Killswitch: "off"

    killswitch-on:
      chain:
        middlewares: [killswitch-page, killswitch-gate]

    killswitch-gate:
      ipAllowList:
        sourceRange: ["192.168.0.0/16"]   # die eigenen Netze
        rejectStatusCode: 418

    killswitch-page:
      errors:
        status: ["418"]
        service: killswitch@docker       # ein kleiner nginx mit der Wartungsseite
        query: "/"
        statusRewrites:
          "418": 503
Umgeschaltet wird mit einer Zeile pro Gruppe, etwa killswitch-php von «aus» auf «an». Ein
Push auf den Hauptzweig, und nach wenigen Minuten ist die Gruppe auf allen Proxys gesperrt.
Weder Traefik noch die Anwendungen starten dafür neu.
Wer gesperrt ist, sieht diese Seite statt einer Fehlermeldung:
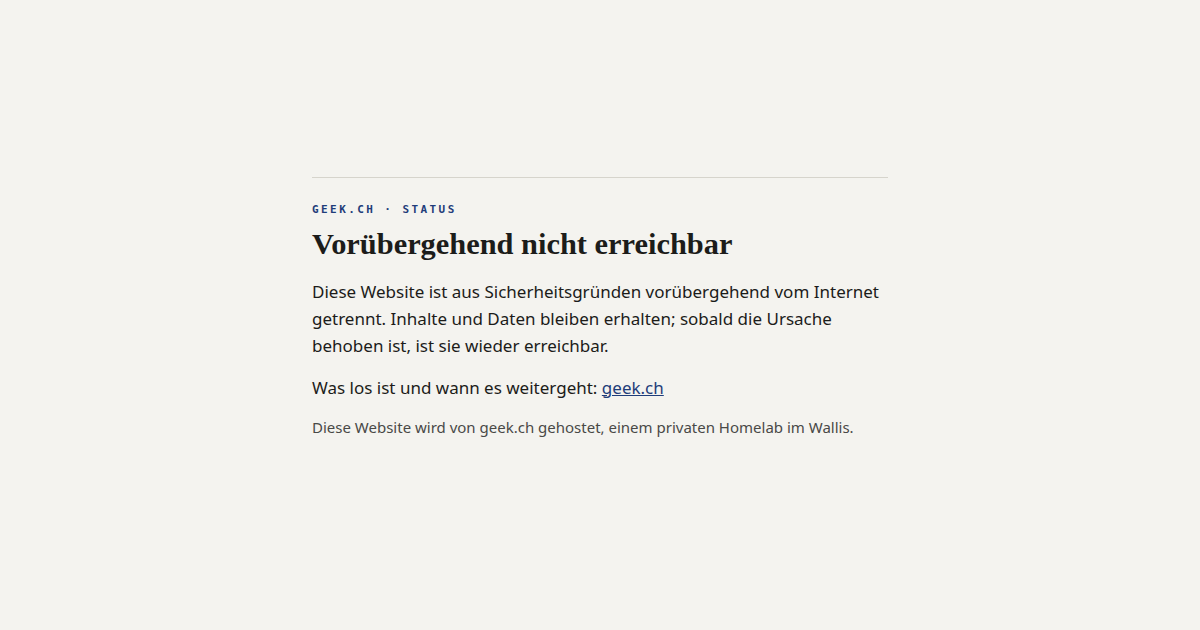
Sie lädt nichts nach, keine Schrift, kein Stylesheet, und schickt noindex und no-store mit.
Eine Sperrmeldung gehört weder in eine Suchmaschine noch in einen Browser-Cache.
Lieber zu als offen
Fehlt der Baustein mit der Wartungsseite, deaktiviert Traefik jeden Router, der darauf verweist. Dann sind alle Dienste mit einer Gruppe weg, auch die, deren Gruppe gerade auf «aus» steht. Das ist Absicht: Ein Killswitch, der im Zweifel offen bleibt, ist keiner.
Damit der Schalter im Ernstfall auch wirklich funktioniert, prüft das Monitoring laufend eine Adresse, die immer gesperrt ist. Zeigt sie keine Wartungsseite mehr, gibt es einen Alarm, bevor wir den Schalter brauchen.
Was wir dabei gelernt haben
- Eine kaputte Konfigurationsdatei nimmt alles mit. Traefik verwirft eine ungültige
dynamische Datei ganz, nicht nur den fehlerhaften Teil. Ein harmlos aussehendes
headers: {}als «leere» Middleware reicht dafür. Deshalb läuft jetzt vor jedem Push eine Prüfung gegen einen echten Traefik. - Nicht jeder Dienst lässt sich am selben Ort sperren. Bei Diensten, deren Verschlüsselung erst hinter dem ersten Proxy endet, sieht der erste Proxy nur verschlüsselten Verkehr. Gesperrt werden muss dort, wo TLS terminiert wird. Wer das am falschen Ort versucht, sperrt nicht nur die Externen aus, sondern alle. Das ist uns während des Aufbaus einmal für rund eine Viertelstunde passiert.
- Ein Router ohne Gruppe ist ein Loch. Die Sperre wirkt nur dort, wo die Gruppe hängt. Wer einen neuen Dienst aufschaltet, hängt die Gruppen gleich mit an.
Was der Killswitch nicht ist
Er ersetzt kein Update. Er verschafft Zeit, bis eines da ist, und er schützt nur gegen Angriffe von aussen. Was im internen Netz verwundbar ist, bleibt es, bis gepatcht ist. Bei PHP2Shell hat er genau das getan, wofür er gebaut wurde: Die betroffenen Websites waren von aussen gesperrt, bis die Updates eingespielt waren, und danach mit einer Zeile wieder offen.